
 事業グロース

企業のデータは、現実にはきれいなリレーショナルデータベースだけに存在しているわけではありません。
JSON、CSV、Excel、CRM、ERP、メール、PDF、契約書、Webページ、APIレスポンス。さらに同じ対象であっても、システムごとに名前も構造も異なります。
たとえば、あるシステムでは次のようになっています。
{
  "company": "ABC株式会社",
  "president": "山田太郎",
  "sales": "約3億円"
}
別のシステムでは、こうです。
{
  "organization": {
    "name": "ABC"
  },
  "representative": {
    "name": "山田 太郎"
  },
  "revenue": 300000000
}人間なら、この2つがほぼ同じ対象について書かれている可能性にすぐ気づきます。しかし計算機にとって、company と organization、president と representative、sales と revenue は、それぞれ別の記号にすぎません。
ここで必要になるのが、「データそのものではなく、データが表している意味構造をモデル化する」という発想です。
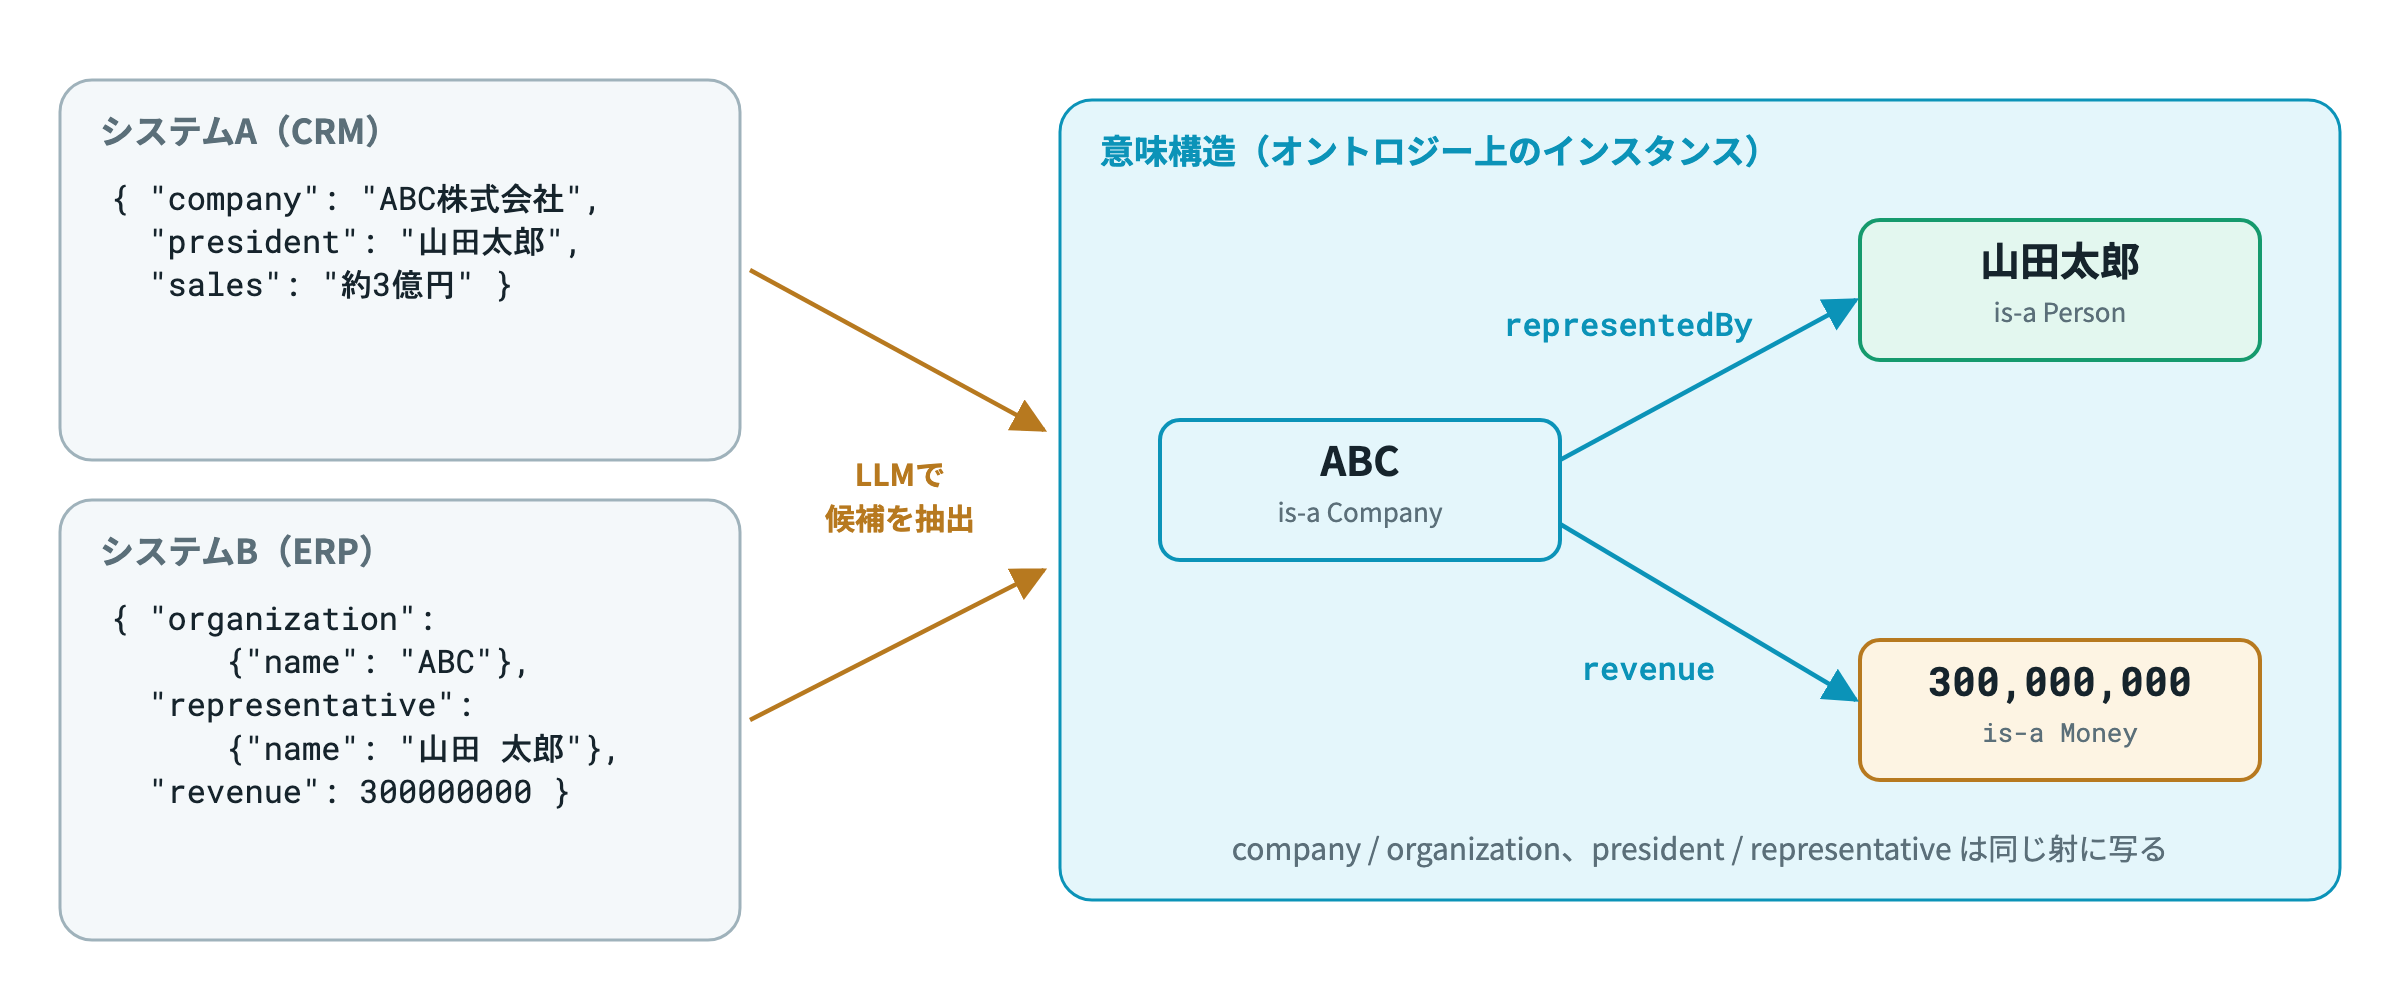
そのための道具の一つがオントロジーであり、さらに異なる構造同士の対応を数学的に扱うための強力な言語が圏論です。
この記事は二部構成です。前半では、オントロジーと圏論でデータ統合をどう捉えるかを整理します。後半では、それを Amazon Bedrock と Knowledge Bases で動かす最小のコード(Python 約280行・一式を配布)に落とし、一行ずつ数学との対応を確かめます。
1. データを「値の集合」ではなく「関係の構造」として見る
まず、企業について次のデータがあるとします。
会社名 = ABC株式会社
代表者 = 山田太郎
顧客   = XYZ株式会社
売上   = 3億円
通常のデータ処理では、それぞれをフィールドと値として扱います。しかし見方を変えると、これは関係のネットワークです。
ABC株式会社
    │
    ├──代表者──→ 山田太郎
    │
    ├──顧客────→ XYZ株式会社
    │
└──売上────→ 3億円ここで重要なのは「ABC株式会社」という文字列そのものではありません。重要なのは次のような意味です。
ABC株式会社 is-a Company
山田太郎    is-a Person
ABC株式会社 representedBy 山田太郎
これがオントロジー的な発想への入口になります。
2. オントロジーは「世界に何が存在し、どう関係できるか」を定義する
たとえば企業情報を扱うオントロジーとして、Company・Person・Project・Contract・Invoice・Payment・Money という概念を定義します。さらに、概念同士の関係を定義します。
Company  ──representedBy──→ Person
Person   ──worksOn────────→ Project
Company  ──hasContract────→ Contract
Contract ──generates──────→ Invoice
Invoice  ──paidBy─────────→ Payment
Payment  ──amount─────────→ Money
ここで「ABC株式会社」「山田太郎」「案件A」「契約書123」「請求書456」「300万円」といった実データは、この意味構造に対する具体的なインスタンスになります。
ただし、「オントロジー = 圏」とそのまま考えるのは、説明としては便利ですが数学的には少し粗いです。より正確には、「オントロジーやデータスキーマのうち、対象・射・合成として扱いたい部分を圏として形式化する」と考えたほうがよいでしょう。
3. スキーマを圏として表現する
圏 C は、大まかには次の4つからできています。
- 対象(Object)
- 射(Morphism)
- 射の合成
- 恒等射
企業データのスキーマで考えます。対象を Company・Project・Invoice・Money とし、射を次のように置きます。
worksOn : Company → Project
invoice : Project → Invoice
amount  : Invoice → Money
射は、行き先と出どころが合えば合成できます。したがって amount ∘ invoice ∘ worksOn は Company → Money という新しい射になります。
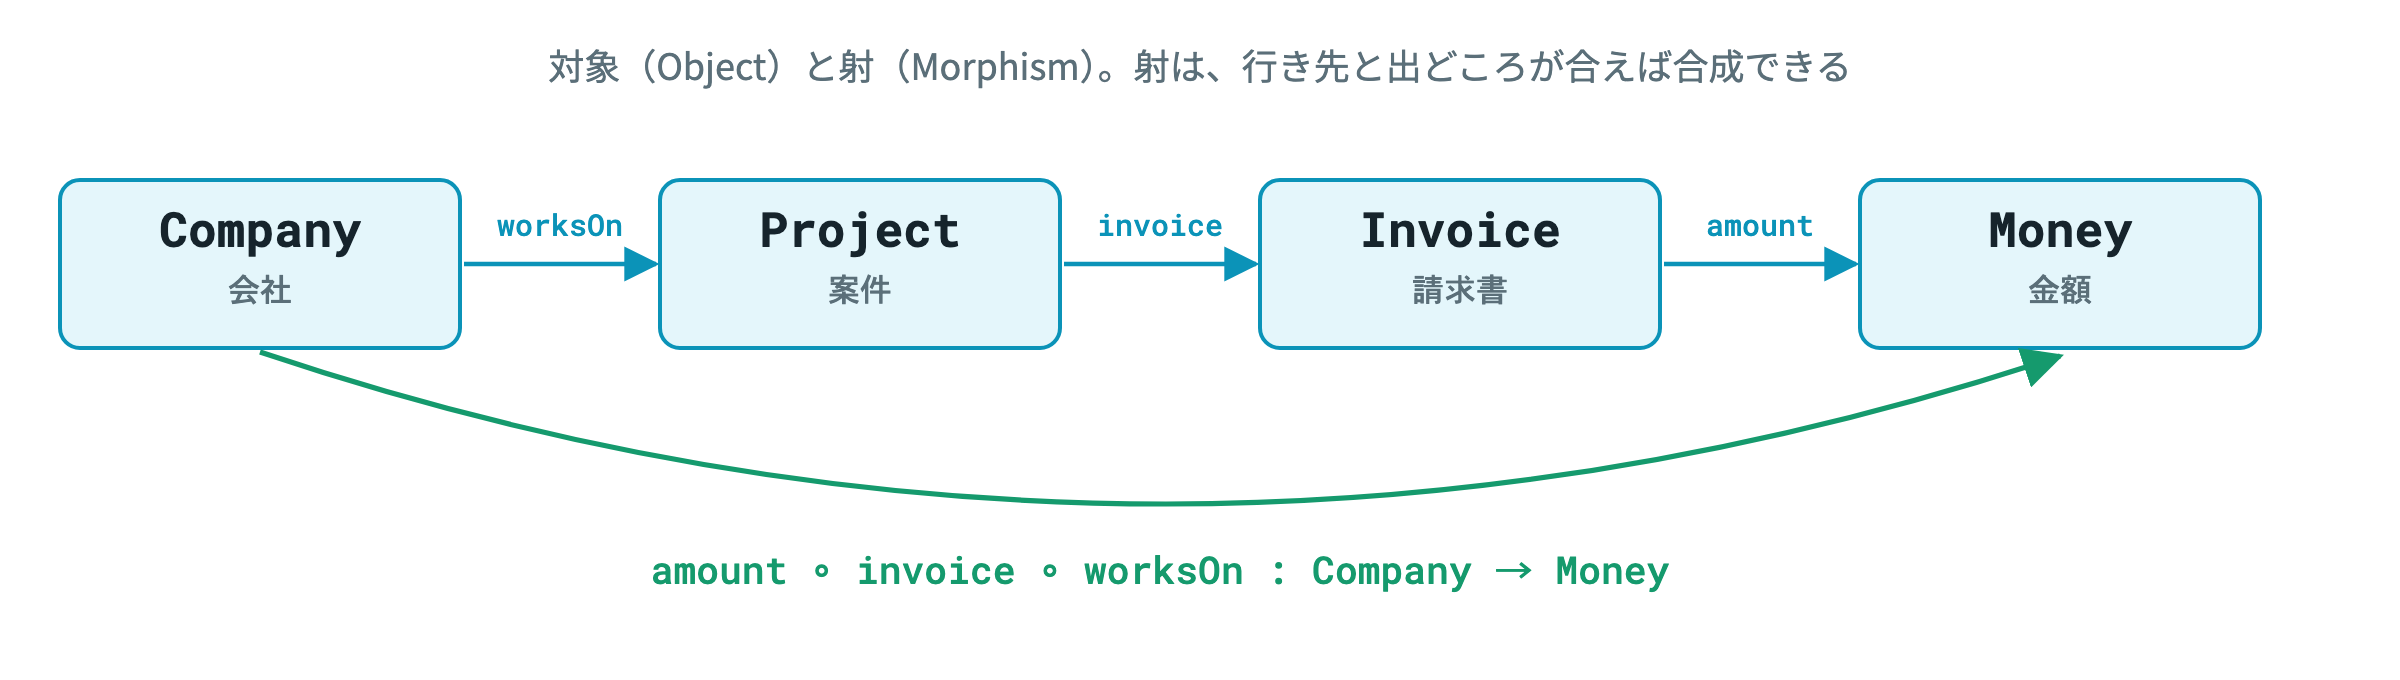
実務的には、これは「会社 → 案件 → 請求書 → 金額」というデータ探索の経路に相当します。
4. 圏論は「値」ではなく「構造」を扱う
通常のプログラミングでは、「ABC株式会社」「300万円」「山田太郎」といった値に注目します。圏論的なデータモデルでは、Company → Project → Invoice → Money という構造そのものに注目します。
つまり、「どの値が入っているか」より先に、「どの種類のものから、どの種類のものへ関係が存在するか」を考えます。これによって、個々のシステム固有のデータ形式から一段抽象化できます。
5. データインスタンスを関手として考える
ここから圏論らしい部分に入ります。スキーマを圏 C とし、具体的なデータを集合の圏 Set へ写す関手を考えます。
I : C → Setこれがデータインスタンスです。スキーマの対象 Company と Person は、それぞれ具体的な集合に写ります。
I(Company) = { ABC株式会社, XYZ株式会社, DEF株式会社 }
I(Person)  = { 山田太郎, 佐藤花子, 鈴木一郎 }
さらにスキーマに representative : Company → Person という射があるとき、関手 I はこの射を具体的な関数へ写します。
I(representative) : I(Company) → I(Person)

ABC株式会社 → 山田太郎
XYZ株式会社 → 佐藤花子
DEF株式会社 → 鈴木一郎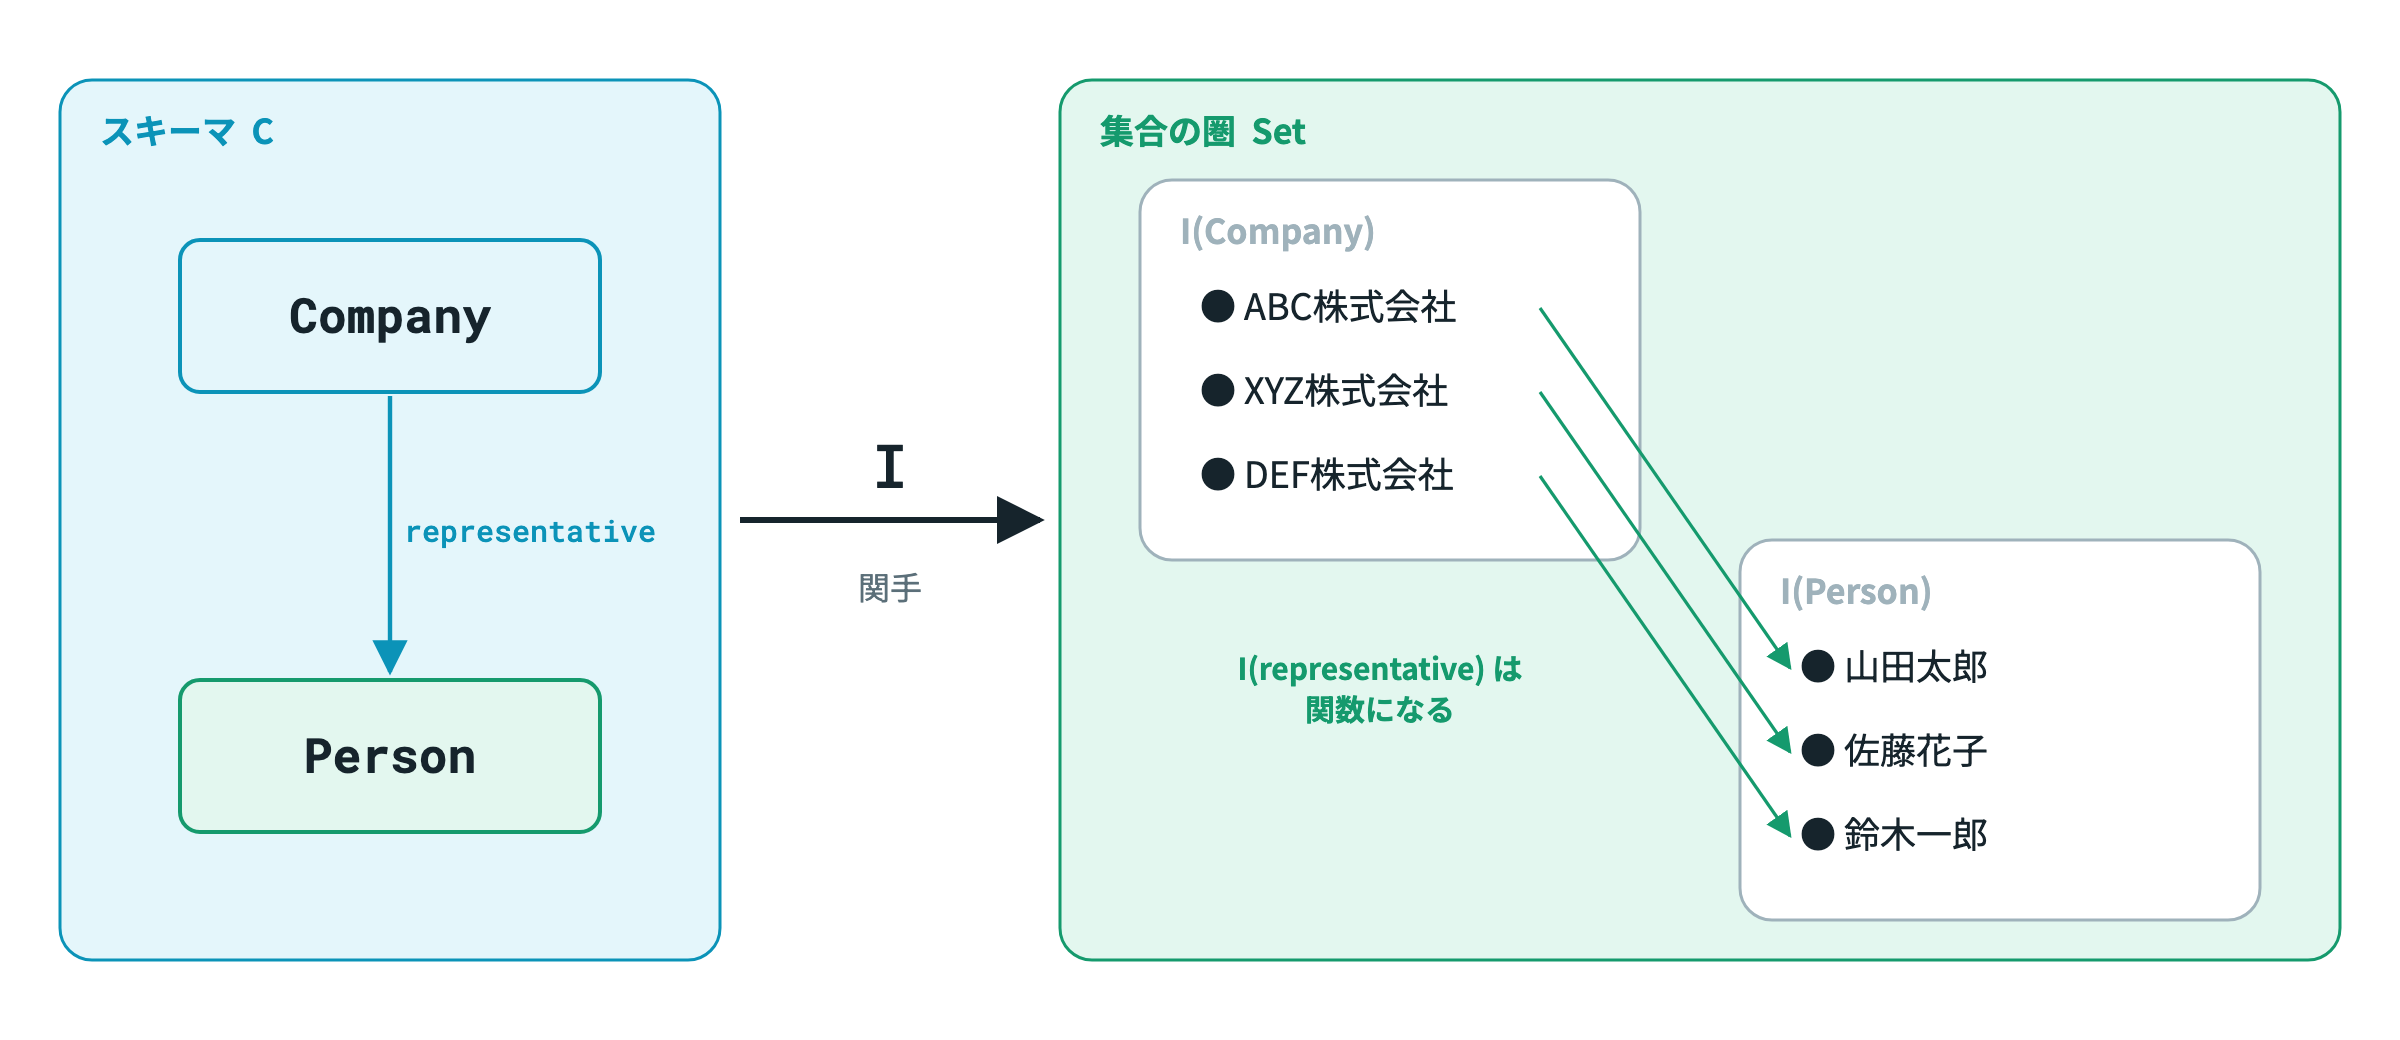
つまり、「スキーマが圏であり、具体的なデータはその圏から Set への関手」として表現されます。
6. 「スキーマ」と「データ」を数学的に分離できる
この考え方によって、「構造」と「具体的な値」をはっきり分けられます。スキーマは C、データは I : C → Set です。したがって同じスキーマに対して、異なるインスタンスを持てます。
I_2024 : C → Set
I_2025 : C → Set
I_2026 : C → Set
データベースでいえば Schema と Instance の分離に近いものです。しかし圏論を使うと、その関係をさらに一般化できます。
7. 異なるシステム間を関手で接続する
CRM には Customer・Contact・Opportunity があり、ERP には BusinessPartner・Employee・Order・Invoice があり、企業共通オントロジーには Company・Person・Project・Transaction があるとします。それぞれを C_CRM・C_ERP・C_Enterprise という圏として表現します。
CRM から企業オントロジーへの対応を関手 F : C_CRM → C_Enterprise として定義します。
Customer    → Company
Contact     → Person
Opportunity → Project
ERP についても G : C_ERP → C_Enterprise を定義します。
BusinessPartner → Company
Employee        → Person
Order           → Transaction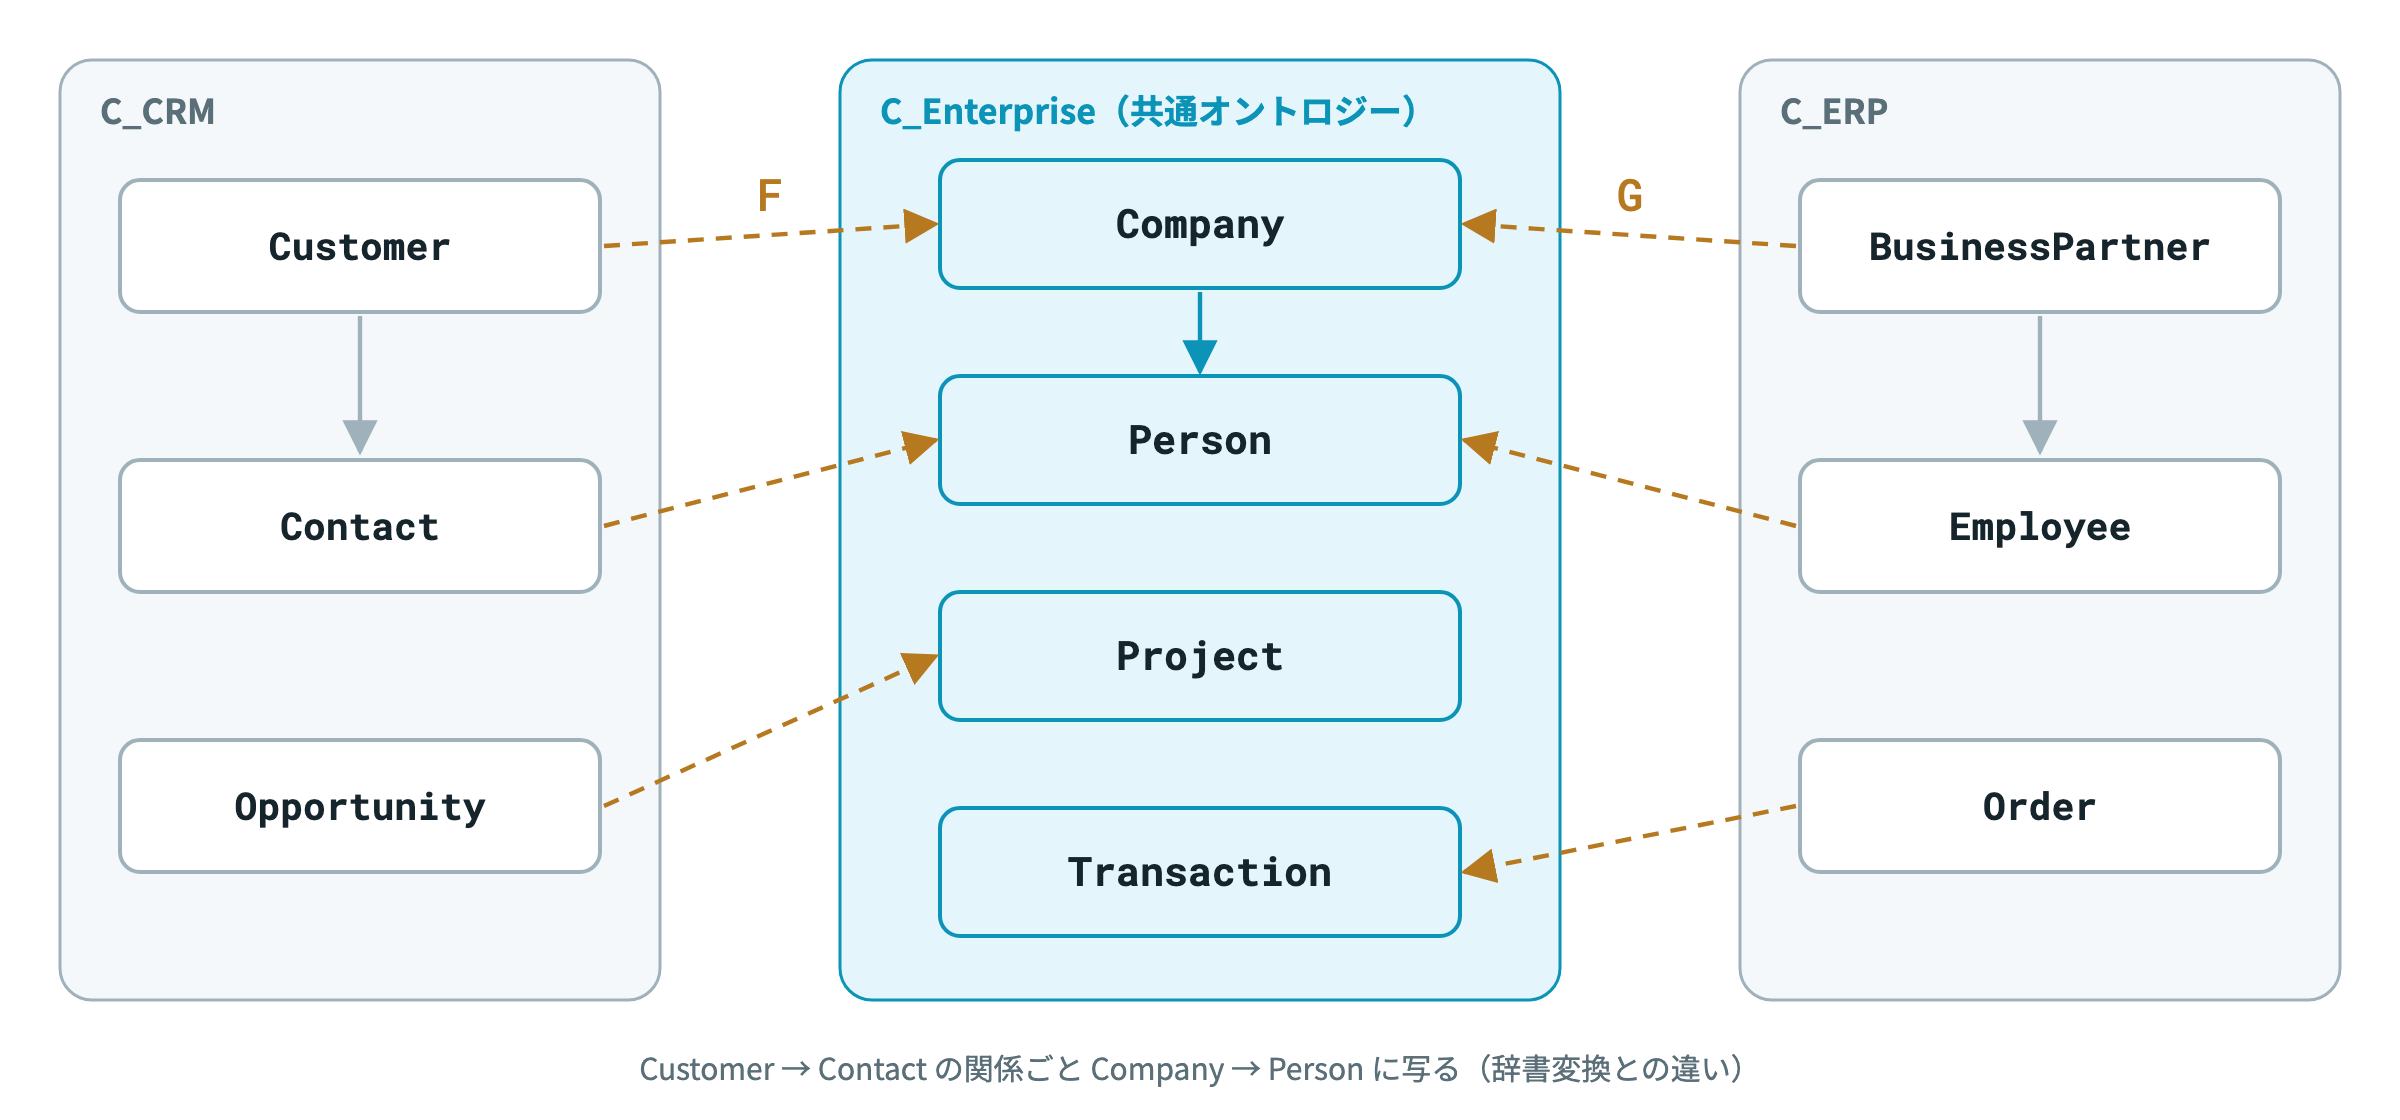
これによって、Customer = BusinessPartner という文字列レベルの定義をする必要がなくなります。両者が Company という共通概念へ写されることで、意味的な対応が生まれます。
8. 重要なのは「構造を保つ」こと
関手は単なる名前変換ではありません。圏の構造を保存します。
CRM に Customer → Contact という関係があれば、企業オントロジー側ではそれが Company → Person に対応します。つまり、Customer → Contact という構造そのものが Company → Person へ移されます。
これが、customer = company という単純な辞書変換との大きな違いです。対象だけでなく、対象間の関係まで含めて変換します。
9. 可換図式によって「意味の整合性」を表現する
現実のデータでは、同じ情報へ複数の経路から到達できます。たとえば案件の責任者には、2つの経路でたどり着けます。
Project ──managedBy──→ Person
Project ──department──→ Department ──head──→ Person
もし両方の経路が同じ責任者を表すべきなら、2つの合成が一致すること、つまり managedBy = head ∘ department を要求できます。これが可換図式の考え方です。
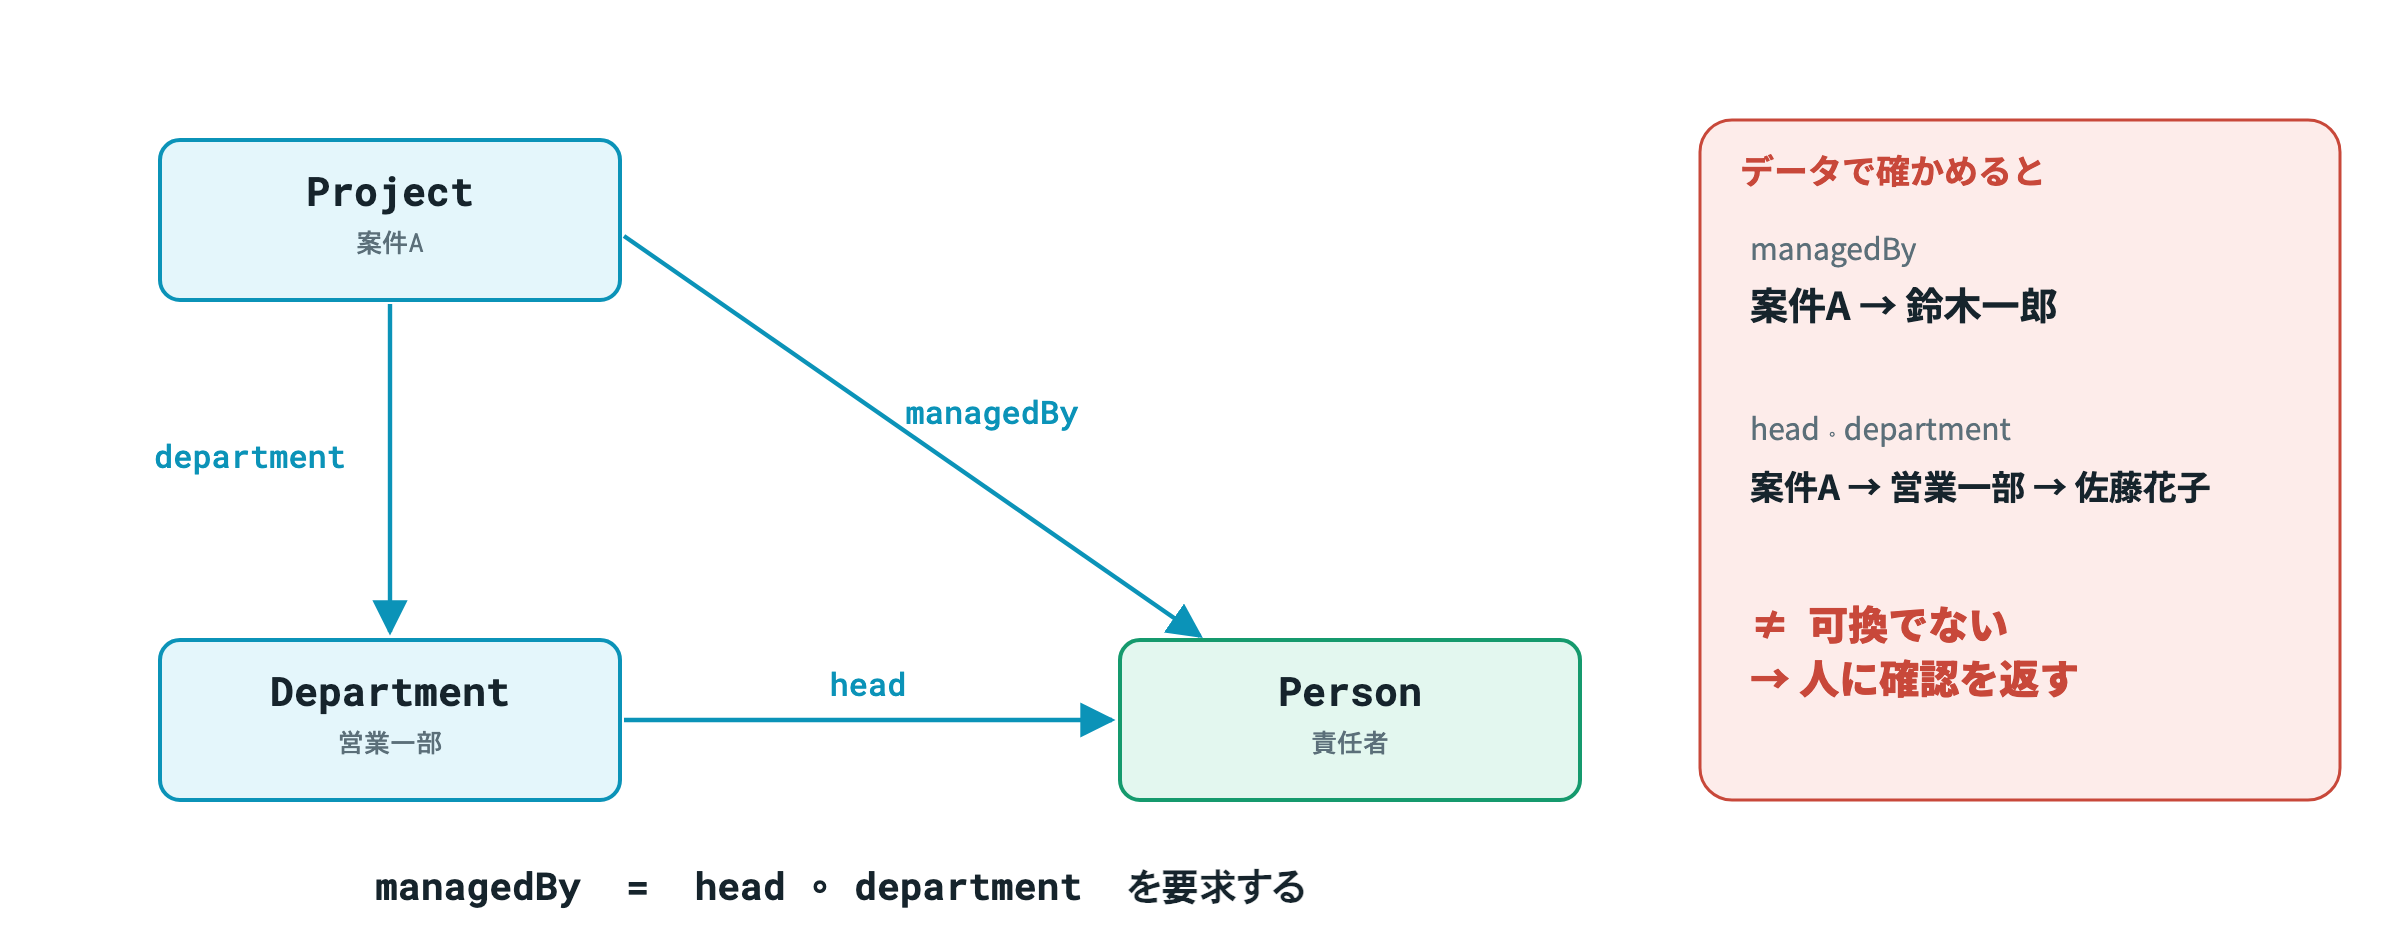
データ統合の文脈では、「異なるシステム・異なる経路から取得した情報が意味的に整合しているか」を表すモデルとして使えます。後半の実装では、この検査を実際に走らせ、一致しなかった案件を人に返します。
10. 自然変換——「変換そのもの」を比較する
さらに一段抽象化します。同じスキーマから別のスキーマへの変換方法が複数ある場合があります。
F : C → D   (変換ルールA)
G : C → D   (変換ルールB)
この2つの関手の間の体系的な対応を、自然変換 η : F ⇒ G として表現できます。
重要なのは、個々のデータをバラバラに対応させるのではない点です。すべての対象について対応が存在し、その対応が射と整合することを要求します。データ統合の世界でいえば、「変換ルールのバージョン間の整合性」を考える数学的な枠組みに近いものです。
11. データ移行そのものを圏論として考える
スキーマ間に関手 F : C → D があるとします。すると、このスキーマ変換から、データそのものを移動させる操作を構成できます。代表的なのが次の3つのデータ移行関手です。
Σ_F ⊣ Δ_F ⊣ Π_Fこの3つの間には随伴関係があります。直感的には次のように捉えられます。
- Δ_F:既存の構造に沿ってデータを見る(引き戻す)操作
- Σ_F:データを統合しながら前方へ移す操作
- Π_F:条件を満たす形でデータを構成する操作
ここまで来ると、「圏論をデータベースにたとえている」のではありません。スキーマ間の関手から、データ移行の操作そのものを数学的に構成できるのです。
12. Limit——複数の条件を満たす情報を集める
乱雑な企業データでは、情報が分散しています。
CRM          → 会社情報
会計         → 請求情報
メール       → 担当者情報
契約書       → 契約条件
プロジェクト → 案件情報これらを単純に連結すると矛盾が生まれます。そこで重要になるのが圏論の極限(Limit)です。直感的には、「複数の情報源の条件を同時に満たす対象を構成する」という考え方です。たとえば CRM 上の会社と会計上の会社が、共通の Company ID を介してつながっているとき、次の Pullback を考えられます。
          統合Company
         ↙          ↘
      CRM          Accounting
         ↘          ↙
          Company ID
データベース的には JOIN に近いものです。ただし Limit は JOIN より一般的で、複数の整合条件を持つ複雑な図式全体について、その条件を同時に満たすデータを考えられます。
13. Colimit——異なる情報源を統合する
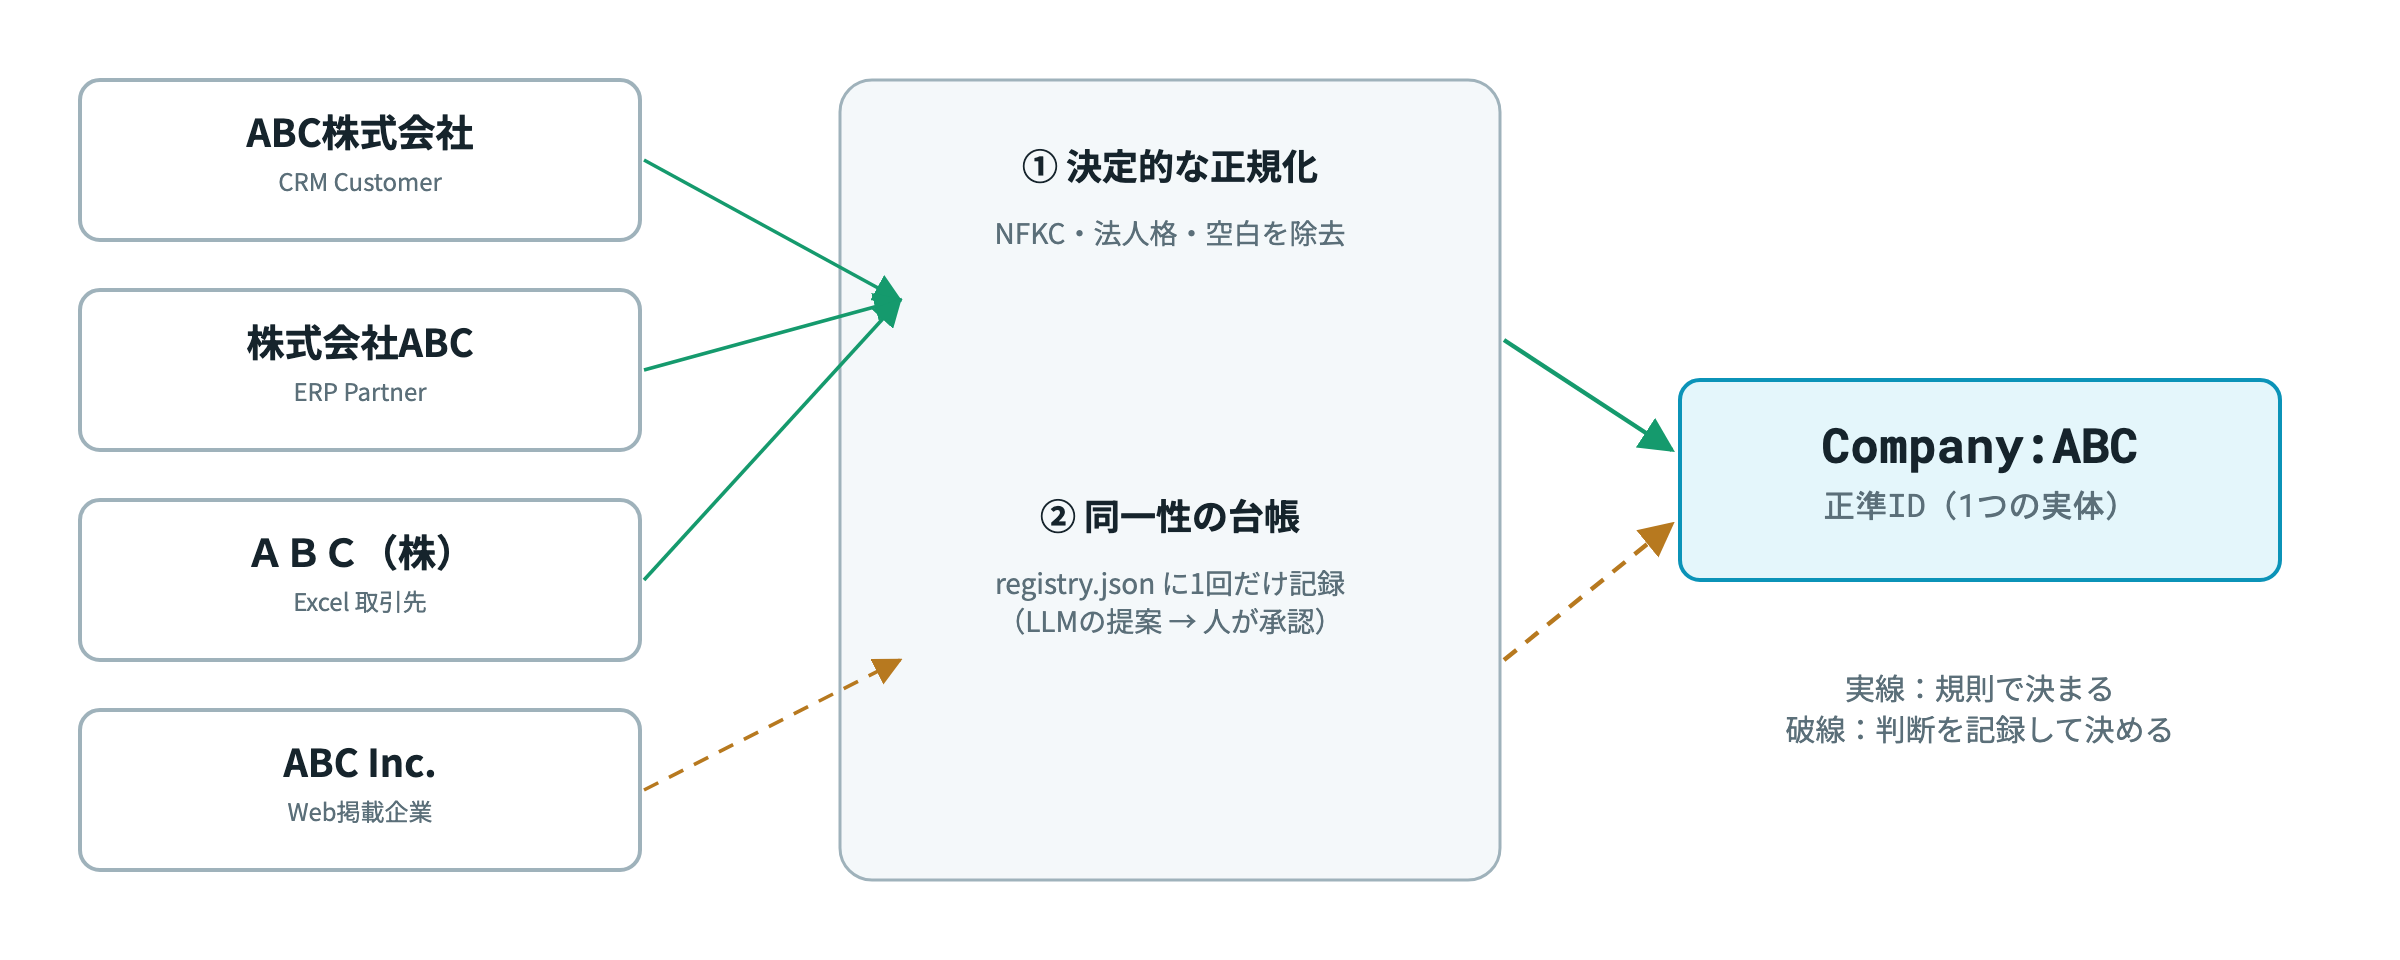
逆方向で重要なのが余極限(Colimit)です。CRM Customer・ERP BusinessPartner・Excel の取引先・Web 掲載企業 という異なる情報源を、Company という共通概念へ統合したいとします。
もちろん、単純に全部を結合すればよいわけではありません。
ABC株式会社
株式会社ABC
ABC Inc.
ABC Co., Ltd.これらが同一企業なのかを判定する必要があります。「同一性をどう与えながら、複数の情報源を一つの構造へ統合するか」という問題に、Colimit 的な考え方を当てはめられます。
14. ここで LLM が登場する
圏論やオントロジーには一つ大きな問題があります。現実のデータは最初から Company・Person・Contract・Invoice と分類されているわけではない、という点です。実際には、メール本文・PDF・Excel・議事録・チャット・契約書・Webページ・CSV・画像として存在しています。
そこで LLM を使います。たとえばメールから次の候補を抽出します。
{ "subject": "ABC株式会社", "predicate": "hasContract", "object": "XYZ株式会社" }契約書からは次の候補を、議事録からは次の候補を抽出します。
{ "subject": "契約123", "predicate": "amount", "object": 3000000 }
{ "subject": "山田太郎", "predicate": "worksOn", "object": "Project A" }
つまり LLM を、「乱雑な現実世界から意味構造の候補を抽出する装置」として使います。
15. LLM と圏論は役割が違う
ここはとても重要です。LLM は確率的で、圏論は数学的です。
LLM に「ABC株式会社と山田太郎の関係は?」と聞くと、「代表取締役である可能性が高い」という確率的な判断ができます。一方オントロジー側では、Company ──representedBy──→ Person という許容される意味構造を定義します。つまり、全体を次のような構造にできます。
Raw Data
    ↓
LLM
    ↓
Entity / Relation 候補
    ↓
Ontology Mapping
    ↓
Schema Validation
    ↓
Categorical Structure
LLM にすべてを任せるのではありません。
- LLM は「意味の候補」を発見する
- オントロジー は「意味」を定義する
- 圏論 は「意味構造同士の関係」を定義する
この役割分担が重要になります。
16. LLM だけでデータ統合すると何が問題なのか
LLM だけでも、「この2つは同じ会社ですか?」「この人物はこの会社の代表者ですか?」「この契約書と請求書は関連していますか?」という推論はできます。しかし毎回 LLM に問い合わせると、判断が確率的になります。
昨日は ABC株式会社 = ABC Inc. と判断し、今日は ABC株式会社 ≠ ABC Inc. と判断する可能性があります。
さらにデータ量が増えると、すべての関係を毎回 LLM に推論させるのは、コストの面でも応答時間の面でも現実的ではなくなります。1万社どうしの同一性を毎回聞き直せば、それだけで約5,000万組です。
問題はコストだけではありません。LLM の判断はどこにも残らないので、「なぜこの2社を同じと見なしたのか」を後から説明できません。監査にも耐えません。
17. 判断を「構造」に固定する
解決の方向ははっきりしています。LLM が出した判断を、その都度使い捨てにせず、検証してから構造として固定することです。
- 候補がスキーマに合うか(射の出どころと行き先の型が合っているか)は、機械的に判定できる
- 関数であるべき射(会社の代表者は1人)が本当に関数になっているかも、機械的に判定できる
- 2つの経路が一致すべきところが可換になっているかも、機械的に判定できる
- 「ABC Inc. は ABC株式会社と同じ」という同一性の判断は、一度決めたら台帳に記録し、二度と聞き直さない
LLM は「候補を出す係」にとどめ、保存するのは検証を通った事実と、その根拠の場所だけにします。ここからは、これを実際に Amazon Bedrock の上で組んでみます。
18. 実装:Bedrock と Knowledge Bases で組む全体像
使う部品は3つです。
| 部品 | 役割 | 記事前半との対応 |
|---|---|---|
| Amazon Bedrock Knowledge Bases | 乱雑な文書をチャンク化・埋め込みし、根拠の文章を検索する | Raw Data の置き場 |
| Claude on Amazon Bedrock | 文書から、スキーマで許された三つ組だけを JSON で抜き出す | LLM(候補の抽出) |
| ontology.py(標準ライブラリのみ) | 型・関数性・可換性・同一性を検証し、関手 I を組み立てる | オントロジーと圏 |
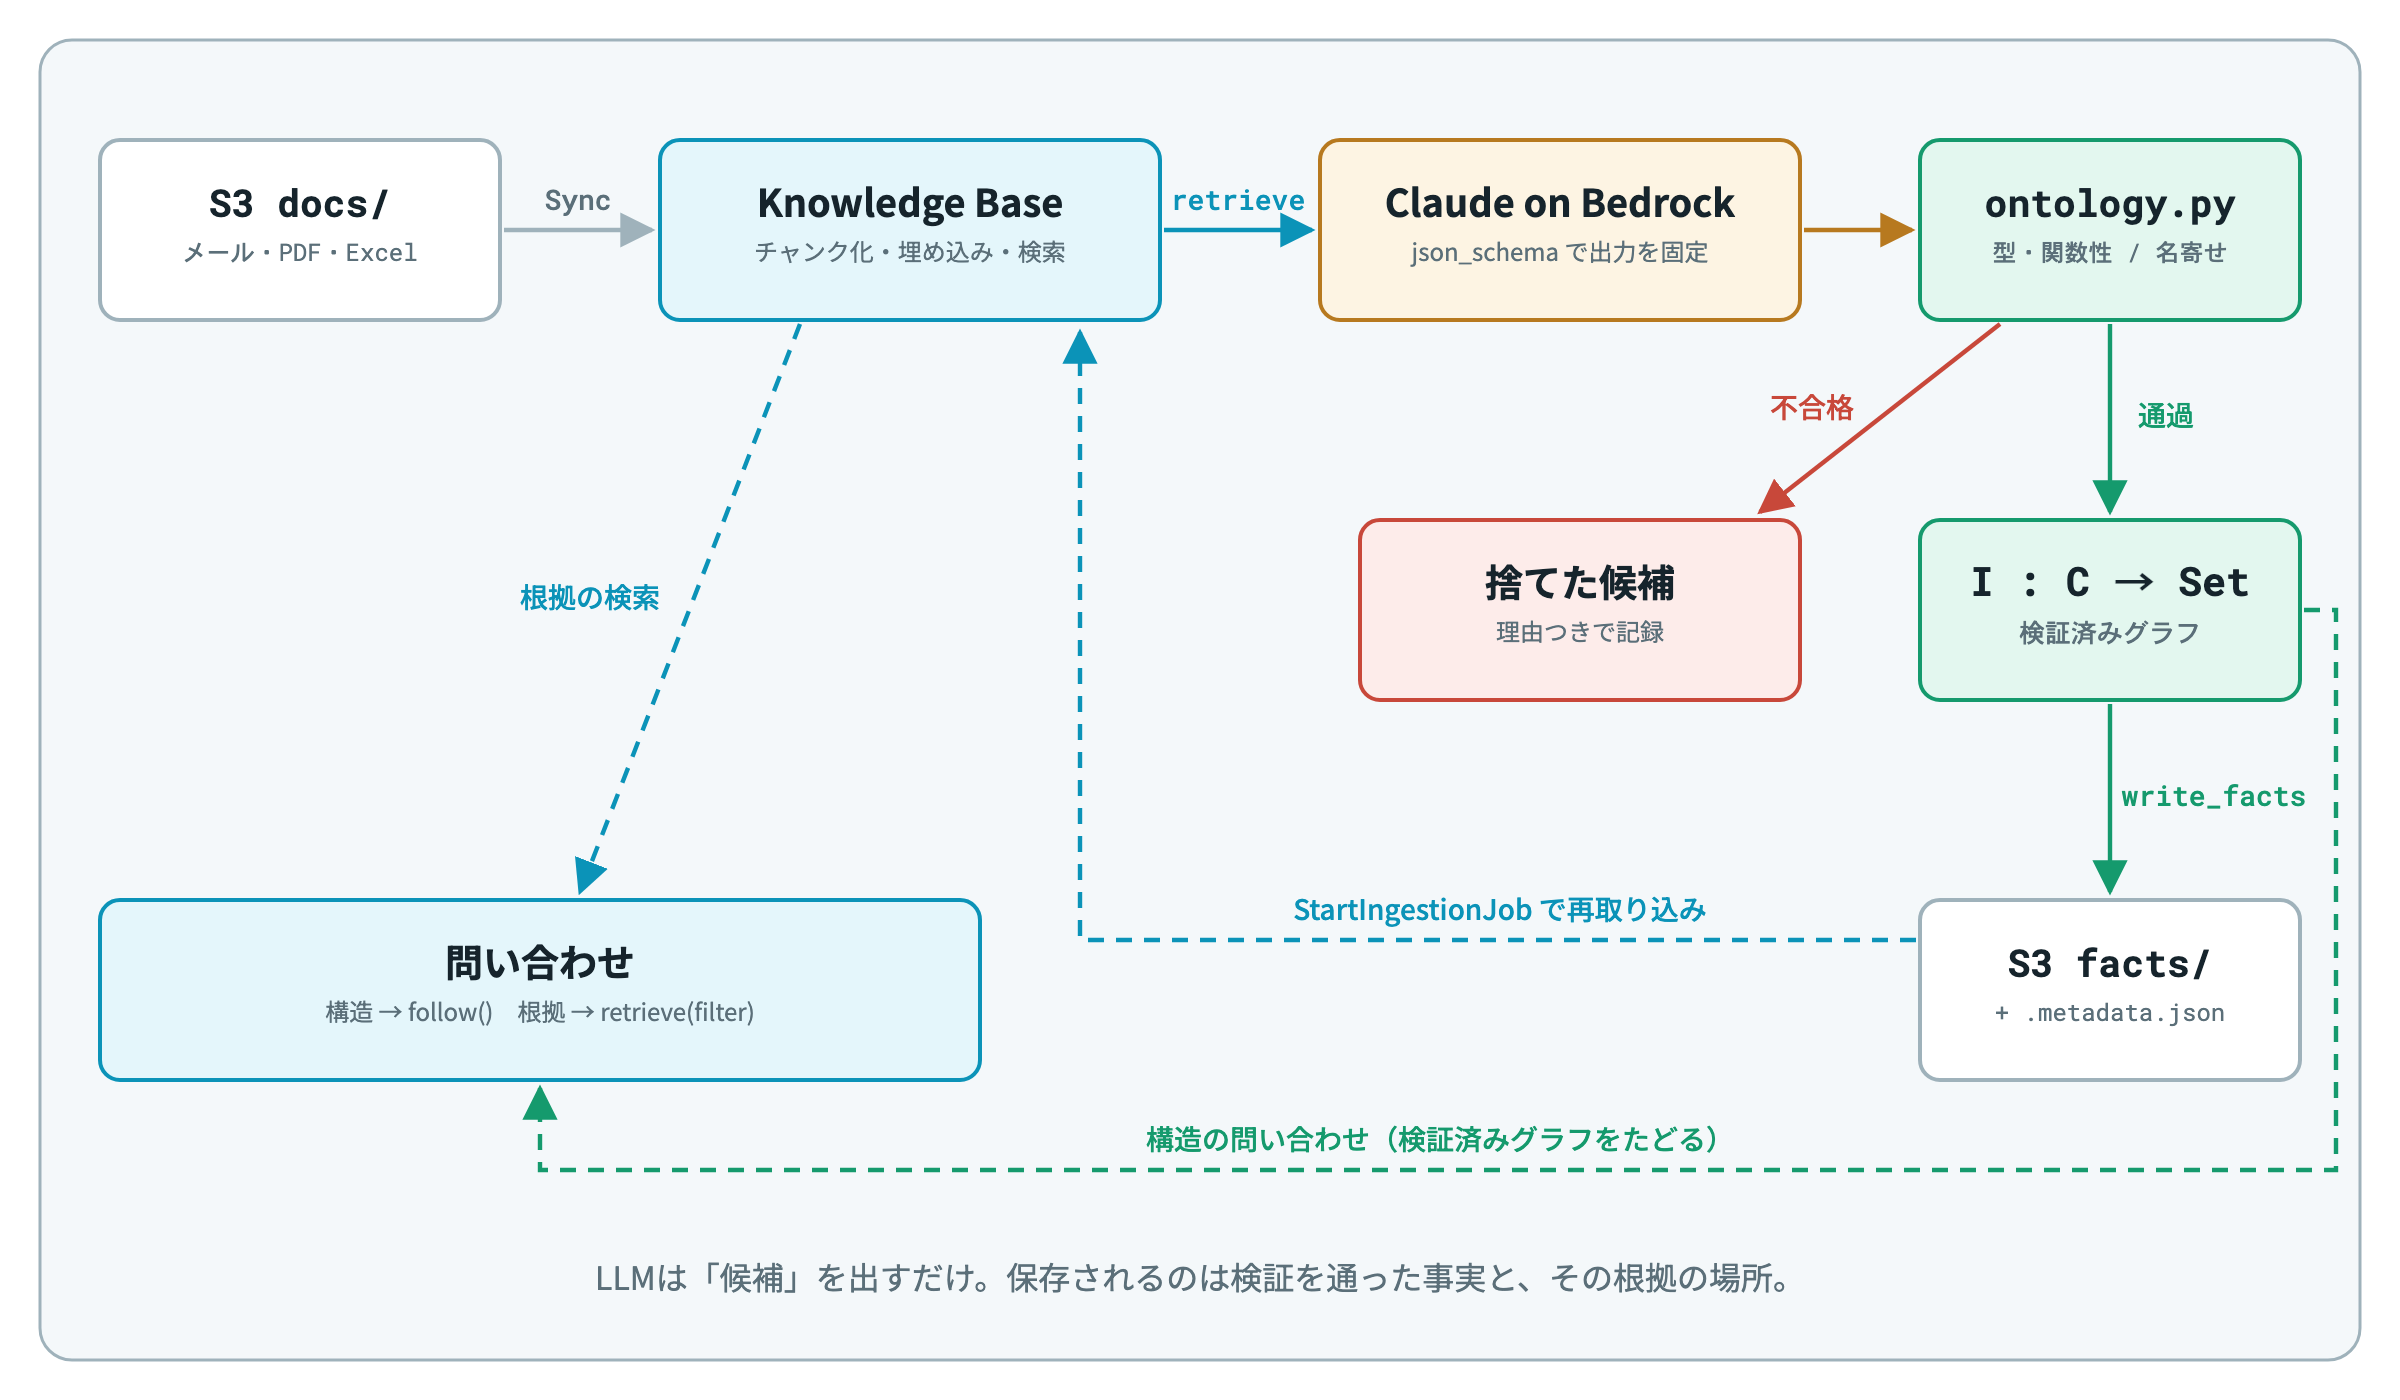
流れは次のとおりです。
- メール・PDF・Excel などを S3 の
docs/に置き、Knowledge Base に取り込む(Sync) - Knowledge Base の
RetrieveAPI で、関係がありそうな文章チャンクを取る - Claude に、スキーマから自動生成した JSON Schema で三つ組を出させる
ontology.pyで検証し、通ったものだけで関手I : C → Setを組み立てる。通らなかったものは理由つきで記録する- 検証済みの事実を S3 の
facts/にメタデータ付きで書き戻し、Knowledge Base に再取り込みさせる
コード一式は次からダウンロードできます。AWS を使わずに検証部分だけ動かすこともできます。
- ontology-kb-0.1.0.tar.gz(6.7KB)
- sha256:
b59ea77cdc67669de906c4ebec71ef5c1cbdce1736181d3acf40f36efa132ac2
ontology-kb/
├── schema.json         スキーマ(対象と射)
├── ontology.py         圏・関手・可換性・同一性の台帳(標準ライブラリのみ)
├── kb.py               Knowledge Base 検索 / Claude による抽出 / 事実の書き戻し
├── run.py              一周させるスクリプト
├── mock_triples.json   AWS なしで試すための「LLM が返しそうな候補」
├── requirements.txt
└── README.md
19. スキーマを書く——圏 C を JSON で宣言する
まず圏 C そのものを JSON で書きます。対象(objects)と射(morphisms)だけです。前半の例に合わせて、案件の責任者に至る2つの経路(managedBy と department → head)も入れておきます。なお実装では、会社から案件への射を前半の worksOn ではなく hasProject と名付けています。
{
  "objects": ["Company", "Person", "Department", "Project", "Contract", "Invoice", "Money"],
  "morphisms": [
    {"name": "representedBy", "src": "Company",    "dst": "Person"},
    {"name": "hasContract",   "src": "Company",    "dst": "Contract", "functional": false},
    {"name": "hasProject",    "src": "Company",    "dst": "Project",  "functional": false},
    {"name": "department",    "src": "Project",    "dst": "Department"},
    {"name": "managedBy",     "src": "Project",    "dst": "Person"},
    {"name": "head",          "src": "Department", "dst": "Person"},
    {"name": "invoice",       "src": "Project",    "dst": "Invoice",  "functional": false},
    {"name": "amount",        "src": "Invoice",    "dst": "Money"}
  ]
}
functional は、その射がデータ上で関数になるべきかどうかです。会社の代表者は1人(関数)ですが、会社の案件は複数あってよい(関数ではない=関係)ので false にしています。厳密にいえば、関数でない射は Set ではなく「関係の圏」Rel への写し方になります。最小実装では同じ仕組みで扱い、関数性のチェックだけを切り替えています。
20. 圏と合成を書く
スキーマを読み込み、射の合成を定義します。合成できるのは、前の射の行き先と次の射の出どころが一致するときだけです。
@dataclass(frozen=True)
class Morphism:
    name: str
    src: str               # dom
    dst: str               # cod
    functional: bool = True  # True なら I(f) は「関数」(1つの src に dst は1つ)


@dataclass
class Schema:
    objects: set
    morphisms: dict        # name -> Morphism

    def compose(self, *names):
        """射の合成。amount ∘ invoice ∘ worksOn は compose("worksOn","invoice","amount")。"""
        path = [self.morphisms[n] for n in names]
        for f, g in zip(path, path[1:]):
            if f.dst != g.src:
                raise TypeError(f"合成できません: {f.name}: {f.src}→{f.dst} と {g.name}: {g.src}→{g.dst}")
        return path[0].src, path[-1].dst
compose("hasProject", "invoice", "amount") は ("Company", "Money") を返します。compose("amount", "hasProject") のように型が合わない経路は、データを見る前に TypeError で止まります。経路が意味を持つかどうかを、値ではなく構造で判定しているのがポイントです。
21. 関手 I : C → Set を組み立てる——LLM の候補を検証する場所
ここが実装の中心です。LLM が出した三つ組を1件ずつ受け取り、3つの条件で検証してから、関手 I の一部として取り込みます。
@dataclass
class Instance:
    schema: Schema
    registry: Registry
    sets: dict = field(default_factory=dict)       # 対象 -> 要素の集合        = I(X)
    arrows: dict = field(default_factory=dict)     # 射 -> {(a, b), ...}      = I(f)
    rejected: list = field(default_factory=list)

    def add(self, t):
        """LLM が出した候補 1 件を検証して取り込む。通らなければ理由付きで捨てる。"""
        f = self.schema.morphisms.get(t["predicate"])
        if f is None:
            return self._reject(t, "スキーマに無い射")
        if t["subject_type"] != f.src or t["object_type"] != f.dst:
            return self._reject(t, f"型が合わない({f.name} は {f.src}→{f.dst})")
        a = self.registry.resolve(f.src, t["subject"])
        b = self.registry.resolve(f.dst, str(t["object"]))
        pairs = self.arrows.setdefault(f.name, set())
        if f.functional and any(x == a and y != b for x, y in pairs):
            return self._reject(t, f"関数にならない({a} の {f.name} が既に別の値)")
        pairs.add((a, b))
        self.sets.setdefault(f.src, set()).add(a)
        self.sets.setdefault(f.dst, set()).add(b)
        return True
3つのチェックは、それぞれ前半の数学に対応しています。
| チェック | 数学での意味 | 落とすもの |
|---|---|---|
| スキーマに射があるか | 圏 C に存在する射か | LLM が作った架空の関係 |
| 出どころ・行き先の型が合うか | I(f) : I(src) → I(dst) になっているか | 「会社の代表者が会社」のような型違い |
| 関数になっているか | I(f) が写像か(1つの入力に1つの出力) | 代表者が2人いる、のような矛盾 |
合成射をデータ上でたどる follow と、可換性を確かめる commutes も、それぞれ数行です。
    def follow(self, start, *names):
        """合成射をデータ上でたどる。I(g∘f)(x) = I(g)(I(f)(x))。"""
        self.schema.compose(*names)                # 型が合わない経路はここで止まる
        cur = {start}
        for n in names:
            cur = {b for (a, b) in self.arrows.get(n, ()) if a in cur}
        return cur

    def commutes(self, left, right):
        """可換図式のチェック。2 経路の行き先が一致しない要素を返す(空なら可換)。"""
        ...
follow のコメントに書いた I(g∘f)(x) = I(g)(I(f)(x)) は、関手が合成を保つという性質そのものです。スキーマ上で射を合成してからデータに写しても、データ上で関数を順にたどっても、同じ答えになる。だから「会社 → 金額」という問い合わせを、スキーマの言葉で書けます。
22. 同一性の台帳——余極限を「記録された判断」にする
前半16章の「昨日と今日で判断が変わる」問題は、同一性の判断を台帳に固定することで解きます。名寄せを2段に分けています。
LEGAL_FORMS = ["株式会社", "(株)", "有限会社", "合同会社"]


def normalize(name):
    """決定的な正規化。同じ入力は必ず同じキーになる(LLM を呼ばない)。"""
    s = unicodedata.normalize("NFKC", name).strip()      # 全角英数・(株)などを揃える
    for form in LEGAL_FORMS:
        s = s.replace(form, "")                           # 株式会社ABC = ABC株式会社
    return re.sub(r"\s+", "", s)                          # 山田 太郎 = 山田太郎


class Registry:
    """「この名前はこの実体」という判断の台帳。一度決めたら、以後は LLM に聞き直さない。"""

    def resolve(self, obj, name):
        key = f"{obj}:{normalize(name)}"
        return self.same_as.get(key, key)          # 台帳に無ければ自分自身が正準ID

    def merge(self, obj, a, b):
        """人間(または承認済みの LLM 提案)が「a と b は同じ」と決めたときだけ呼ぶ。"""
...- 1段目(規則):
ABC株式会社・株式会社ABC・ABC(株)は、NFKC 正規化と法人格の除去で同じキーCompany:ABCになります。何度実行しても結果は同じです。 - 2段目(判断):
ABC Inc.は規則だけでは同じとは言えません。ここは LLM に候補を出させてもよいのですが、採用するかどうかは人が決め、mergeで台帳(registry.json)に書きます。以後は台帳を引くだけなので、判断が揺れません。
数学的には、これは「同一視の関係で割った商」を作る操作で、図6の余極限にあたります。どの要素を同一視するかという判断の部分だけを外に出して記録しているのが、この実装の設計です。
23. Knowledge Base から根拠を取り、Claude に三つ組を出させる
ここから AWS 側です。まず Knowledge Base の Retrieve API で、根拠になる文章を取ります。
def retrieve(query, k=5, flt=None):
    conf = {"numberOfResults": k}
    if flt:
        conf["filter"] = flt
    res = kb_runtime.retrieve(
        knowledgeBaseId=os.environ["KB_ID"],
        retrievalQuery={"text": query},
        retrievalConfiguration={"vectorSearchConfiguration": conf},
    )
    return [{"text": r["content"]["text"],
             "source": r.get("location", {}).get("s3Location", {}).get("uri", ""),
             "score": r.get("score")}
            for r in res["retrievalResults"]]
次に、取ったチャンクを Claude に渡して三つ組を抜き出させます。ここで大事なのは、出力の JSON Schema をオントロジーから自動生成していることです。predicate と型は enum で縛るので、Claude はスキーマに無い射の名前を出力できません。
def triple_schema(schema):
    """オントロジーから出力スキーマを作る。predicate と型は enum で縛る。"""
    return {
        "type": "object",
        "properties": {"triples": {"type": "array", "items": {
            "type": "object",
            "properties": {
                "subject":      {"type": "string"},
                "subject_type": {"type": "string", "enum": sorted(schema.objects)},
                "predicate":    {"type": "string", "enum": sorted(schema.morphisms)},
                "object":       {"type": "string"},
                "object_type":  {"type": "string", "enum": sorted(schema.objects)},
                "evidence":     {"type": "string"},
                "source":       {"type": "string"},
            },
            "required": ["subject", "subject_type", "predicate", "object",
                         "object_type", "evidence", "source"],
            "additionalProperties": False,
        }}},
        "required": ["triples"],
        "additionalProperties": False,
    }


def extract(schema, chunks):
    arrows = "\n".join(f"- {m.name}: {m.src} -> {m.dst}" for m in schema.morphisms.values())
    docs = "\n\n".join(f"<doc source=\"{c['source']}\">\n{c['text']}\n</doc>" for c in chunks)
    res = claude.messages.create(
        model=MODEL,
        max_tokens=16000,
        system=("あなたは企業データから事実を抜き出す係です。次の射(関係)だけを使ってください。\n"
                f"{arrows}\n"
                "文書に書かれていない関係は推測で作らないこと。evidence には根拠の原文をそのまま、"
                "source には doc の source 属性を入れること。金額は円単位の整数を文字列で書くこと。"),
        messages=[{"role": "user", "content": docs}],
        output_config={"format": {"type": "json_schema", "schema": triple_schema(schema)}},
    )
    if res.stop_reason == "refusal":
        raise RuntimeError("モデルが応答を拒否しました")
    text = next(b.text for b in res.content if b.type == "text")
    return json.loads(text)["triples"]
Claude の呼び出しには Anthropic の Python SDK の AnthropicBedrockMantle クライアントを使っています。認証は通常の AWS 認証情報(IAM ロールやプロファイル)で、モデル ID は環境変数 CLAUDE_MODEL で差し替えられます(既定値は anthropic.claude-opus-5)。
ここで気をつけたいのは、enum で縛れるのは「射の名前」と「型の名前」までだという点です。「ABC株式会社の代表者が XYZ株式会社」のように、名前は正しいが型の組み合わせが間違っている候補は、JSON Schema では防げません。だから次の段で ontology.py の型検査を通します。出力形式の制約(LLM 側)と、意味の検証(数学側)は別物で、両方が必要です。
24. 検証済みの事実を Knowledge Base に書き戻す
検証を通った事実は、1件1ファイルで S3 の facts/ に置きます。Knowledge Bases は、文書と同じ場所にある <ファイル名>.metadata.json をメタデータとして読み込むので、あとから subject_id や predicate で絞り込んで検索できます。
def write_facts(inst):
    """検証済みの事実を 1 件 1 ファイルで S3 に置き、メタデータで引けるようにする。"""
    bucket = os.environ["FACT_BUCKET"]
    for name, pairs in inst.arrows.items():
        m = inst.schema.morphisms[name]
        for a, b in sorted(pairs):
            key = "facts/" + hashlib.sha1(f"{a}|{name}|{b}".encode()).hexdigest()[:16] + ".txt"
            body = f"{a} は {name} によって {b} に対応する。({m.src} → {m.dst})"
            meta = {"metadataAttributes": {
                "subject_id": a, "subject_type": m.src,
                "predicate": name, "object_id": b, "object_type": m.dst}}
            s3.put_object(Bucket=bucket, Key=key, Body=body.encode("utf-8"))
            s3.put_object(Bucket=bucket, Key=key + ".metadata.json",
                          Body=json.dumps(meta, ensure_ascii=False).encode("utf-8"))
    return kb_admin.start_ingestion_job(
        knowledgeBaseId=os.environ["KB_ID"], dataSourceId=os.environ["DS_ID"]
)["ingestionJob"]["ingestionJobId"]キーは「主語・射・目的語」のハッシュなので、同じ事実を何度書いても同じファイルが上書きされるだけで、重複しません。書き戻したあとは、たとえば次のように正準IDで絞った検索ができます。
retrieve("ABCの代表者は?",
         flt={"equals": {"key": "subject_id", "value": "Company:ABC"}})
こうして、問い合わせを2種類に分けられます。
- 構造の問い合わせ:「ABC の案件の請求額は?」→
follow()で検証済みグラフをたどる。答えは決定的 - 根拠の問い合わせ:「なぜそう言えるのか?」→ Knowledge Base から、元の文章と保存した事実を検索する
25. 動かしてみる
AWS を使わずに検証部分だけ試すには、--mock を付けて実行します。mock_triples.json には、LLM が返しそうな候補を10件入れてあります。そのうち2件はわざと間違えた候補です(会社の代表者が会社になっているもの、代表者が2人目として出てくるもの)。
tar xzf ontology-kb-0.1.0.tar.gz && cd ontology-kb
python3 run.py --mock
run.py は、候補を取り込む前に reg.merge("Company", "ABC株式会社", "ABC Inc.") で同一性の判断を1件だけ台帳に記録しています。実行結果は次のとおりです。
== I(X): 対象ごとの集合
  Company    ['Company:ABC']
  Department ['Department:営業一部']
  Invoice    ['Invoice:請求書456']
  Money      ['Money:3000000']
  Person     ['Person:佐藤花子', 'Person:山田太郎', 'Person:鈴木一郎']
  Project    ['Project:案件A']

== 捨てた候補
  ABC株式会社 -representedBy-> XYZ株式会社 : 型が合わない(representedBy は Company→Person)
  ABC株式会社 -representedBy-> 田中次郎 : 関数にならない(Company:ABC の representedBy が既に別の値)

== 合成射 amount ∘ invoice ∘ hasProject(会社 → 金額)
  Company:ABC → ['Money:3000000']

== 可換性 managedBy = head ∘ department(案件の責任者)
  Project:案件A: ['Person:鈴木一郎'] ≠ ['Person:佐藤花子']  → 要確認
読み取れることを整理します。
- 表記ゆれが1つの実体になった。CRM の
ABC株式会社と ERP のABC Inc.は、どちらもCompany:ABCに集まりました。山田太郎と山田 太郎も同じPerson:山田太郎です。 - LLM の誤りが、理由つきで落ちた。「代表者が XYZ株式会社」は型違い、「代表者が田中次郎」は関数性違反として記録されています。黙って捨てずに記録しているので、後で人が見直せます。
- 合成射で問い合わせができた。「会社 → 案件 → 請求書 → 金額」を1本の射としてたどり、300万円に届いています。
- 可換でない箇所が見つかった。案件Aの PM(鈴木一郎)と、担当部署の部長(佐藤花子)が一致しません。これはデータの誤りとは限りません。「PM と部長は別の人でよい」のなら、間違っているのは制約のほうです。どちらにしても、機械は勝手に片方を採らず、人に確認を返します。
実際に Bedrock で動かすときは、--mock を外して次の環境変数を設定します。上の結果は --mock で得たもので、Bedrock に接続した場合の抽出結果は、手元の文書とモデルによって変わります。
pip install -r requirements.txt
export AWS_REGION=ap-northeast-1
export KB_ID=xxxxxxxxxx DS_ID=xxxxxxxxxx FACT_BUCKET=your-bucket
export CLAUDE_MODEL=anthropic.claude-opus-5   # リージョンで使えるモデルIDに合わせる
python3 run.py
Knowledge Base は、S3 をデータソースにしてコンソールから作成しておきます(埋め込みモデルとベクトルストアはコンソールの既定のままで構いません)。必要な IAM 権限は、bedrock:Retrieve・bedrock:StartIngestionJob・s3:PutObject と、Claude を呼び出す権限です。
26. 数学とコードの対応表
| 数学 | 記事前半 | コード |
|---|---|---|
| 圏 C | スキーマ | schema.json / Schema |
| 射の合成 | 会社 → 案件 → 請求書 → 金額 | Schema.compose() |
| 関手 I : C → Set | データインスタンス | Instance.sets と Instance.arrows |
| I(f) が写像であること | 代表者は1人 | functional のチェック |
| 関手が合成を保つ | I(g∘f) = I(g)∘I(f) | Instance.follow() |
| 可換図式 | managedBy = head ∘ department | Instance.commutes() |
| 余極限(同一視の商) | 表記ゆれの統合 | normalize() と Registry |
| LLM | 意味の候補を出す装置 | kb.extract()(出力は JSON Schema で固定) |
27. この最小実装で、あえてやっていないこと
誇張しないために、やっていないことも書いておきます。
- Σ_F・Δ_F・Π_F によるデータ移行は実装していません。本気でやるなら、関手的データ移行の専用ツール(CQL など)の領域です。この記事の実装は、1つのスキーマ上での検証までです。
- 関手 F(CRM → 共通オントロジー)は、コード上では明示していません。LLM への指示と JSON Schema で「共通オントロジーの射だけを使え」と縛ることで、実質的に F の役割を LLM に担わせています。F を辞書として書き、写した後に構造が保たれているかを検査する、というのが次の一歩です。
- 同一性の判断を LLM に提案させる部分は入れていません。
mergeを呼ぶのは人です。候補を出させること自体はextractと同じ要領で作れます。 - グラフはメモリ上にあるだけです。永続化は
facts/への書き戻しとregistry.jsonのみです。規模が大きくなれば、グラフデータベースに載せることになります。Bedrock Knowledge Bases 自体にも Amazon Neptune Analytics を使ったグラフ検索(GraphRAG)の構成がありますが、あちらはグラフを自動で組み立てる仕組みです。自分たちで決めたオントロジーの制約を通すかどうかが、この記事の構成との違いです。
まとめ
乱雑なデータ統合の難しさは、「同じものを同じと言えないこと」と「一度言えたことが、次も言えるとは限らないこと」の2つにあります。
LLM は、前者に対してとても強力です。メールや議事録から、人間が読むのと同じように関係を読み取ってくれます。しかし後者、つまり判断を安定させ、説明できる形で残すことは、LLM の仕事ではありません。そこはオントロジーで意味を定義し、圏論の言葉で構造を検査する側の仕事です。
- LLM は「意味の候補」を出す
- オントロジーは「許される意味」を決める
- 圏論は「構造が保たれているか」を検査する
- そして、判断は台帳に記録して、二度と聞き直さない
Bedrock と Knowledge Bases を使えば、この役割分担を数百行のコードで組めます。配布しているコードはあくまで出発点です。自社のスキーマを schema.json に書き込むところから試してみてください。
合同会社FIELDでは、こうした社内データの統合・AI活用の設計から実装までご相談を承っています。お気軽にお問い合わせください。

